

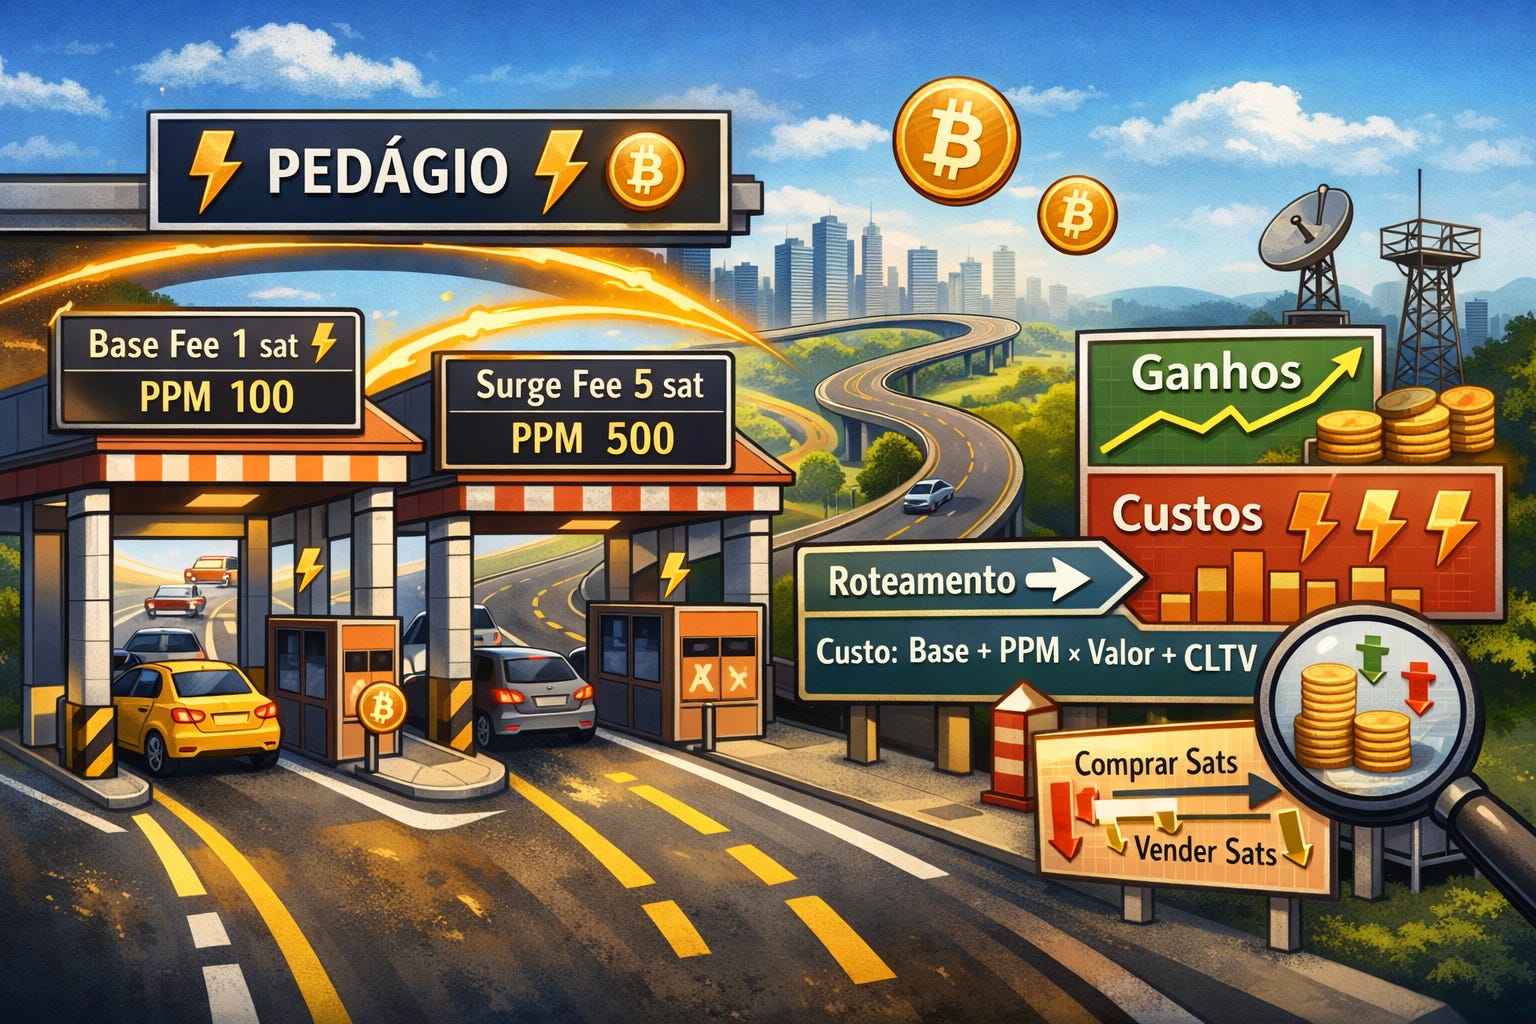
Se a Lightning Network é um sistema de estradas entre cidades (nós), as taxas (fees) são o pedágio que você cobra (ou paga) para que carros (pagamentos) passem pela sua rodovia (canais).
Só que aqui o pedágio não é “um preço único”: ele é uma política por canal, com dois componentes (base fee e ppm), e impacta diretamente:
Qual rota os pagadores escolhem (você vira atalho… ou vira estrada abandonada)
Como sua liquidez se move (você drena um canal até secar, ou mantém o fluxo saudável)
Sua margem (receita de roteamento menos custo de reposição de liquidez/rebalance)
Este guia é denso e técnico: é sobre fee policy como ferramenta de engenharia de tráfego. Automação ajuda, mas antes você precisa entender e saber operar manualmente, porque fee é um ponto crítico para um nó roteador: é literalmente o “preço” do seu estoque de sats.
1) O que você realmente está precificando (e por quê)
Em LN, você não “vende uma transação”. Você vende serviço de liquidez:
Quando você encaminha um HTLC, você empresta liquidez outbound do seu canal de saída por alguns segundos/minutos (até o pagamento completar).
Em troca, você recebe uma taxa.
Se esse tráfego drenar o canal, você precisa repor liquidez (rebalance, swap, abertura/fechamento on-chain) — isso tem custo.
Lucro de roteamento não é “taxa alta”. É:
lucro = fees coletadas − custo de repor liquidez − custos operacionais (on-chain, swaps, tempo, risco)
Se você cobra pedágio barato numa estrada que vive lotando e exige manutenção cara, você quebra. Se você cobra pedágio caro demais e ninguém passa, você também quebra.
2) Fee policy na prática: base fee + ppm (e a matemática do pedágio)
A política padrão de fee em LN é composta por:
Base fee (fixa): em msat por encaminhamento (ex.: 0, 1000msat, 2000msat…)
Fee rate (proporcional): em ppm (parts-per-million) sobre o valor encaminhado
A forma de pensar é:
fee_total_msat = base_fee_msat + amount_msat × ppm / 1.000.000
2.1) O “ponto de virada” (quando a base fee deixa de importar)
Uma pergunta muito útil:
Em que valor a parte proporcional (ppm) fica igual à base?
Resolva:
base_fee_msat = amount_msat × ppm / 1e6
amount_msat = base_fee_msat × 1e6 / ppm
Exemplo:
base = 1000msat (= 1 sat)
ppm = 100
Então:
amount_msat = 1000 × 1e6 / 100 = 10.000.000 msat
10.000.000 msat = 10.000 sats
Interpretação: abaixo de ~10k sats, a base fee pesa muito; acima disso, o ppm domina.
2.2) Consequência prática
Se você quer desincentivar micropagamentos (muita carga por pouca receita), suba base fee.
Se você quer precificar “carga pesada” (pagamentos grandes), ajuste ppm.
💡 Analogia: base fee é o pedágio mínimo por carro; ppm é o pedágio por tonelada de carga.
3) Como fees afetam roteamento de verdade (a visão de quem paga)
Quem paga um invoice (ou quem constrói uma rota para MPP) tenta minimizar custo/risco.
Na prática, os nós (ex.: LND, CLN) usam variações de Dijkstra/A* com um “peso” por aresta que mistura:
taxa esperada do hop
penalidades por timelock/CLTV (risco de capital preso)
heurísticas de probabilidade (mission control, histórico de falhas, etc.)
Ou seja: fee não é o único fator, mas é um fator forte e “primeira ordem”.
3.1) O detalhe mais ignorado: a fee relevante é a do canal de saída do hop
Quando um pagamento passa pelo seu nó, você coleta fee conforme a política que você anuncia no canal pelo qual você encaminha para o próximo hop.
Então, para você atrair tráfego por um certo caminho:
reduza fee nos canais que você quer que sejam usados como saída
E para você proteger um canal (evitar drenagem):
aumente fee no canal que está ficando sem local
🚦 Eng. de tráfego: fee é o semáforo e o preço do combustível ao mesmo tempo.
4) Liquidez: por que fee policy é também “política de estoque”
Todo canal tem dois lados:
local balance (sats do seu lado) → sua capacidade de enviar por ali / encaminhar como saída
remote balance (sats do outro lado) → sua capacidade de receber por ali / encaminhar para você via aquele peer
Se você é um nó roteador, seu objetivo é manter canais com liquidez utilizável nas direções que dão receita.
4.1) A regra brutal
Canal muito local: você está “com estoque encalhado”. Você quer vender esse outbound (atrair tráfego saindo por ele) → normalmente, fee mais baixa.
Canal muito remote (pouco local): você está “sem estoque” daquele lado. Se continuar roteando como saída, você seca de vez → normalmente, fee mais alta.
Mas cuidado: o mercado é dinâmico. Um canal pode estar remote porque ele é ótimo para inbound. E inbound pode ser valioso (ex.: para receber pagamentos, para atrair tráfego que entra e sai por outro canal, etc.).
5) Como definir base fee e ppm na mão (guia prático e técnico)
Abaixo, um framework que funciona para nó roteador.
5.1) Primeiro: defina seu “preço mínimo por giro de liquidez”
Pense em custo de capital + custo de manutenção.
Uma forma prática:
Estime quanto custa repor liquidez (rebalance) em ppm efetivo
Adicione margem
Se um rebalance típico te custa, por exemplo:
30 sats para mover 100k sats
O custo bruto é:
30 / 100.000 = 0,0003 = 300 ppm
Se você cobra 150 ppm e vive precisando rebalancear, você está pagando para trabalhar.
🧠 “Comprar sats” = pagar custos para posicionar liquidez.
“Vender sats” = coletar fees roteando.
O pulo do gato 🐱👤 é comprar barato e vender caro.
5.2) Use um alvo de “equilíbrio” por canal
Defina um target ratio (ex.: 50/50 ou 60/40) e transforme isso em uma curva de fee.
Exemplo de ideia (não é receita única):
Se local_ratio > 70% → reduza ppm (atrair saída)
Se local_ratio entre 40–70% → mantenha “normal”
Se local_ratio < 30% → aumente ppm agressivamente (proteger o resto)
E o base fee?
base fee baixo (0–1000msat) ajuda a captar micro-roteamento
base fee maior filtra ruído e protege CPU/HTLC slots
5.3) Lembre do HTLC budget e do “custo operacional invisível”
Mesmo com fee “ok”, micropagamentos demais podem:
lotar HTLCs
aumentar falhas
aumentar lockups
Nesse caso:
suba base fee, ou
suba
min_htlc(dependendo do seu stack), ouajuste limites de roteamento (ex.: circuit breaker)
6) Quando subir/descer fees (heurísticas que evitam auto-sabotagem)
6.1) Sinais para subir fee em um canal
canal está drenando local consistentemente (local_ratio caindo)
você está virando “estrada gratuita” para alguém (muito tráfego, pouca receita)
rebalances para repor estão caros (mercado de rotas caro)
você quer proteger outbound para seus próprios pagamentos
6.2) Sinais para descer fee
canal está parado com muito local (estoque parado)
você está perdendo tráfego para rotas alternativas
você quer fomentar volume para construir histórico de sucesso (melhorar probabilidade)
6.3) O erro clássico
Subir fee porque “quero ganhar mais” sem olhar:
elasticidade do tráfego (se existe rota alternativa barata)
posição topológica (você é ponte crítica ou só mais um?)
qualidade do canal (capacidade, estabilidade, peers)
Se tem alternativa, tráfego some. Se você é ponte crítica, você consegue cobrar.
7) Incoming vs outgoing: o que você controla, e como isso vira estratégia
7.1) O “outgoing fee” (o que todo mundo conhece)
É a fee que você anuncia no seu lado do canal — e que você cobra quando encaminha para fora por aquele canal.
Isso você controla com ferramentas padrão (ex.: lncli updatechanpolicy no LND).
7.2) O “incoming fee” (onde a coisa fica avançada)
Aqui o termo costuma confundir.
No modelo clássico, quem controla a fee de tráfego entrando em você por um canal é o seu peer (porque para ele, aquilo é “saída”).
Porém, implementações modernas (notadamente no ecossistema LND) adicionaram a ideia de inbound fee/discount como extensão de política, para você influenciar o preço do tráfego que chega até você por uma borda.
A consequência prática é enorme:
Você consegue precificar inbound liquidity de forma mais granular.
Você consegue “puxar” tráfego para entrar por um canal específico (ex.: canal que você quer encher de local via fluxo de entrada).
⚠️ Compatibilidade: nem todos os nós/implementações tratam essas extensões do mesmo jeito; o impacto real depende de suporte no roteamento e na propagação/uso dessas políticas.
8) Manual antes de automação: por que isso é inegociável
Fee policy é controle de risco.
Automação sem entendimento gera dois tipos de desastre:
Você mata seu volume (fees altas demais, zero rota)
Você vira doador de liquidez (fees baixas demais, drenagem + rebalances caros)
Antes de automatizar, você precisa dominar manualmente:
ler seu fwding history e separar por canal
entender seu local/remote e suas metas por canal
calcular custo de rebalance (ppm efetivo)
testar alterações pequenas e medir impacto
9) A automação da BR⚡LN: brln-autofee (outgoing + incoming) 🤖⚡
A BRLN desenvolveu seu próprio script de automação de fees:
brln-autofee(repositório público) - https://github.com/jvxis/brln-autofeeEle automatiza tanto taxas outgoing quanto taxas incoming
Além disso, o repositório evoluiu para um orquestrador que integra três peças legadas em um único processo:
brln-autofee.py(AutoFee)lndg_AR_trigger.py(gatilho/loop de rebalance via LNDg)ai_param_tuner.py(tuner de parâmetros/overrides)
O BRLN Orchestrator mantém estado persistente em SQLite, encapsula integrações externas e roda em loops com dry-run e modos de operação.
9.1) Dependências e integrações (o que ele espera do seu stack)
Pelo README do projeto:
Python 3.11+
lncliebosno PATH (ou caminhos absolutos)nó LND com LNDg (API HTTP e SQLite acessíveis)
conta Amboss com token GraphQL
opcional: Telegram para alertas
Isso é um sinal importante: o sistema está desenhado para operar fee policy e rebalance de forma coordenada, porque uma coisa sem a outra vira “pedágio sem manutenção”.
9.2) Como a automação pensa (pelas pistas do próprio orquestrador)
O orquestrador menciona ajustes graduais em overrides como:
SURGE_KTOP_REVENUE_SURGE_BUMPREBAL_FLOOR_MARGINOUTRATE_FLOOR_FACTORalém de cooldowns e limites por modo (conservador/moderado/agressivo)
Mesmo sem entrar em implementação linha-a-linha aqui, dá para inferir a filosofia:
SURGE: quando um canal está drenando (muita saída), o sistema aumenta a fee (ou reduz agressividade) para segurar drenagem e capturar margem.
TOP_REVENUE…: canais que mais geram receita recebem tratamento especial (bump/boost), porque são “rodovias premium”.
REBAL_FLOOR_MARGIN: não rebalancear se a margem esperada não paga o custo (rebalance só se fizer sentido econômico).
OUTRATE_FLOOR_FACTOR: ancorar a fee no “ritmo de saída” (outflow) para não ficar barato demais em canal que está sendo sugado.
9.3) Operação com segurança: dry-run e exclusões
O README enfatiza dry-run e gestão de exclusões:
exclusões por pubkey para AutoFee e por channel ID para AR trigger
migração de listas antigas via
migrate-exclusion.pyvariáveis como
EXCL_DRY_VERBOSE=1para verbose em modo consulta
Isso é crucial: fee automation sem uma lista de “canais intocáveis” (ex.: parceiros, canais estratégicos, canais de serviço) vira roulette.
10) Checklist prático para um node roteador lucrativo ✅
Classifique canais: premium (muita demanda), utilitários, experimentais.
Defina metas de liquidez por canal (target ratio) e proteja o que importa.
Modele fees como curva (não como número fixo).
Meça custo de reposição (rebalance) e só “compre sats” se o ROI fecha.
Evite fee wars cegas: volume sem margem é armadilha.
Faça manual primeiro: mude pouco, meça, entenda.
Só então automatize, com guardrails (dry-run, exclusões, limites, alertas).
11) Conclusão: pedágio é preço… mas é também volante 🎛️
Fee policy não é um campo para preencher. É um sistema de controle:
controla tráfego
controla estoque (liquidez)
controla margem
Quando você entende isso, você para de “deixar fee no default” e começa a operar seu nó como um negócio.
E aí sim: automação como a da BR⚡LN deixa de ser muleta e vira multiplicador de performance. ⚡📈